01
摘要
格物以通几,立象以见真。研几承接研究与学习,渐衍、万象、尽意与星穹共同组织长期知识演化。
02
所居与相连
-
巡天 · Radar 独立的外部信号入口
-
通几 · Aletheia 求知主线 · 本档案
-
研几 · Zetesis 主要 Web App;内含渐衍、万象与尽意
-
星穹 · Galaxy 知识成图能力
-
-
星汉 · Nebula 获准内容的公开出口
03
能力与现状
- 研几 · Zetesis 已上线 · 持续重构 把材料、研究、学习、复习与创作组织在同一套主要 Web App 中。
- 渐衍 · Athanor 学习引擎 用增量学习、间隔重复、主动回忆与模型修订维持终身学习。
- 万象 · Myrioscope 模块演化中 让同一知识投射为文章、图谱、闪卡、测验与其他可交互形态。
- 尽意 · Graphesis 产品设计定名 在无限空间中书写、连接、重排与演示知识;布势与叠迹属于其内部机制。
04
名字的来处
“通几”取自方以智《物理小识》“质测即藏通几”:在具体考察中寻找贯通之理。Aletheia 意为去蔽,让学习成为不断显明而非一次抵达。
通几 · Aletheia
摘要
通几(Aletheia)是 Maple 给自己设计的学习与长期知识演化系统。研几 · Zetesis 是主要 Web App,承接材料、研究、学习、复习与创作;渐衍 · Athanor 负责增量学习与终身学习调度;万象 · Myrioscope 让同一知识显成不同形态;尽意 · Graphesis 把关系铺进可书写的空间;星穹 · Galaxy 让既有关系可以被追索和漫游。当前服务已经上线,产品体验和各模块仍在持续演化。
名字取自方以智《物理小识》“质测即藏通几”:具体考察之中,藏着贯通的义理。Aletheia 指向“去蔽、显真”。通几以“格物以通几,立象以见真”为志:从材料与问题出发,形成可以检验、修订与迁移的理解。
产品架构
- 研几 · Zetesis:通几的主要 Web App 与研究学习空间。
- 渐衍 · Athanor:研几内部的增量学习、间隔重复、主动回忆与模型修订引擎。
- 万象 · Myrioscope:知识的多形态投射;卡带是其中的可插拔内容对象。
- 尽意 · Graphesis:空间化知识创作产品;布势组织布局,叠迹 · Palimpsest 保存层次与演化。
- 星穹 · Galaxy:通几内部的知识成图与漫游能力,可嵌入研几,但不取代原始学习事实。
背景与动机
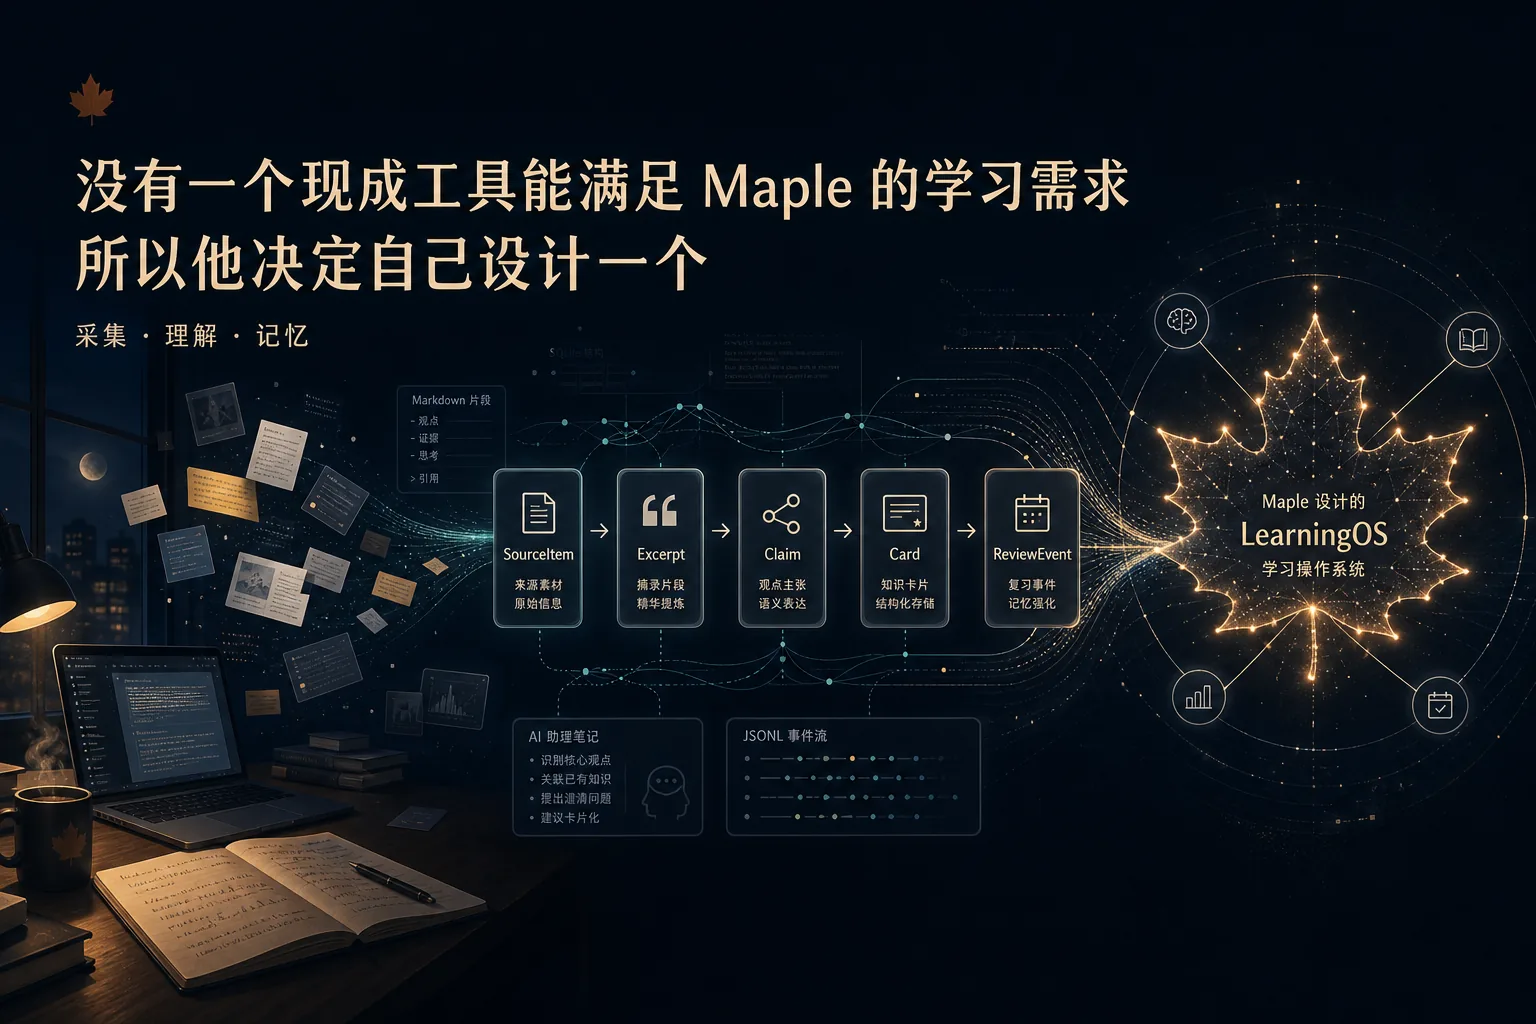
Maple 把市面工具读了一圈(竞品全景:Anki / RemNote / Obsidian / Quizlet / Mochi),结论是没有一个能同时满足三件事:
- 数据完全自控——本地文件、开放格式、不被账号和私有格式绑架
- 交互完全自定——阅读、捕获、复习的界面按自己的认知习惯裁剪,而不是适应产品的交互假设
- AI 深度参与编译——不是“AI 帮你生成卡片”这种表层集成,而是 AI 作为知识库的编译器持续工作
单独看每一条都有工具做到,组合起来一个都没有。至于为什么连最接近的 Obsidian 也不用:它本质是“一堆 .md 文件 + 双链 + 插件”,数据层完全可以自持,前端交互自己做更贴合。自研路线前期投入大,但不被任何产品绑架——对一件打算用一辈子的工具,这笔账是划算的。
更底层的动机是对“学习”本身的立场:应试训练把学习退化成背知识点,而知识的真实形态是世界的模型——概念之间怎么连接、哪里是因果、哪里只是相关。工具应该服务于建模,复习只是维护模型不塌的手段。
系统概览(设计定案)
三环闭环,环环有明确的技术选型:
flowchart TB
    C["01 · 捕获 Capture<br/>浏览器 · iOS · 语音"]
    K["02 · 编译 Compile<br/>LLM Wiki"]
    R["03 · 复习 Review<br/>FSRS"]
    D[("共同数据底座<br/>Markdown · Git")]

    C --> K --> R --> D
    D -. 状态回流 .-> C
三环共享同一份底层数据:捕获写入素材,编译产出知识页,复习读知识页并回写记忆状态——没有任何一环把数据带进私有孤岛。
核心设计(为什么这样定)
编译,而不是整理
传统 PKM(个人知识管理)的失败模式是“整理的巨债”:剪藏一时爽,素材池永远等着人来加工。LLM Wiki 模式把加工外包给 AI:素材进来,AI 负责把它合并进已有的知识页——去重、关联、改写、标注出处。人消费的永远是编译后的稳定层,素材层允许混乱。这和林爝“后台允许混乱、前台保证信噪比”是同一个哲学。
FSRS,而不是传统间隔重复
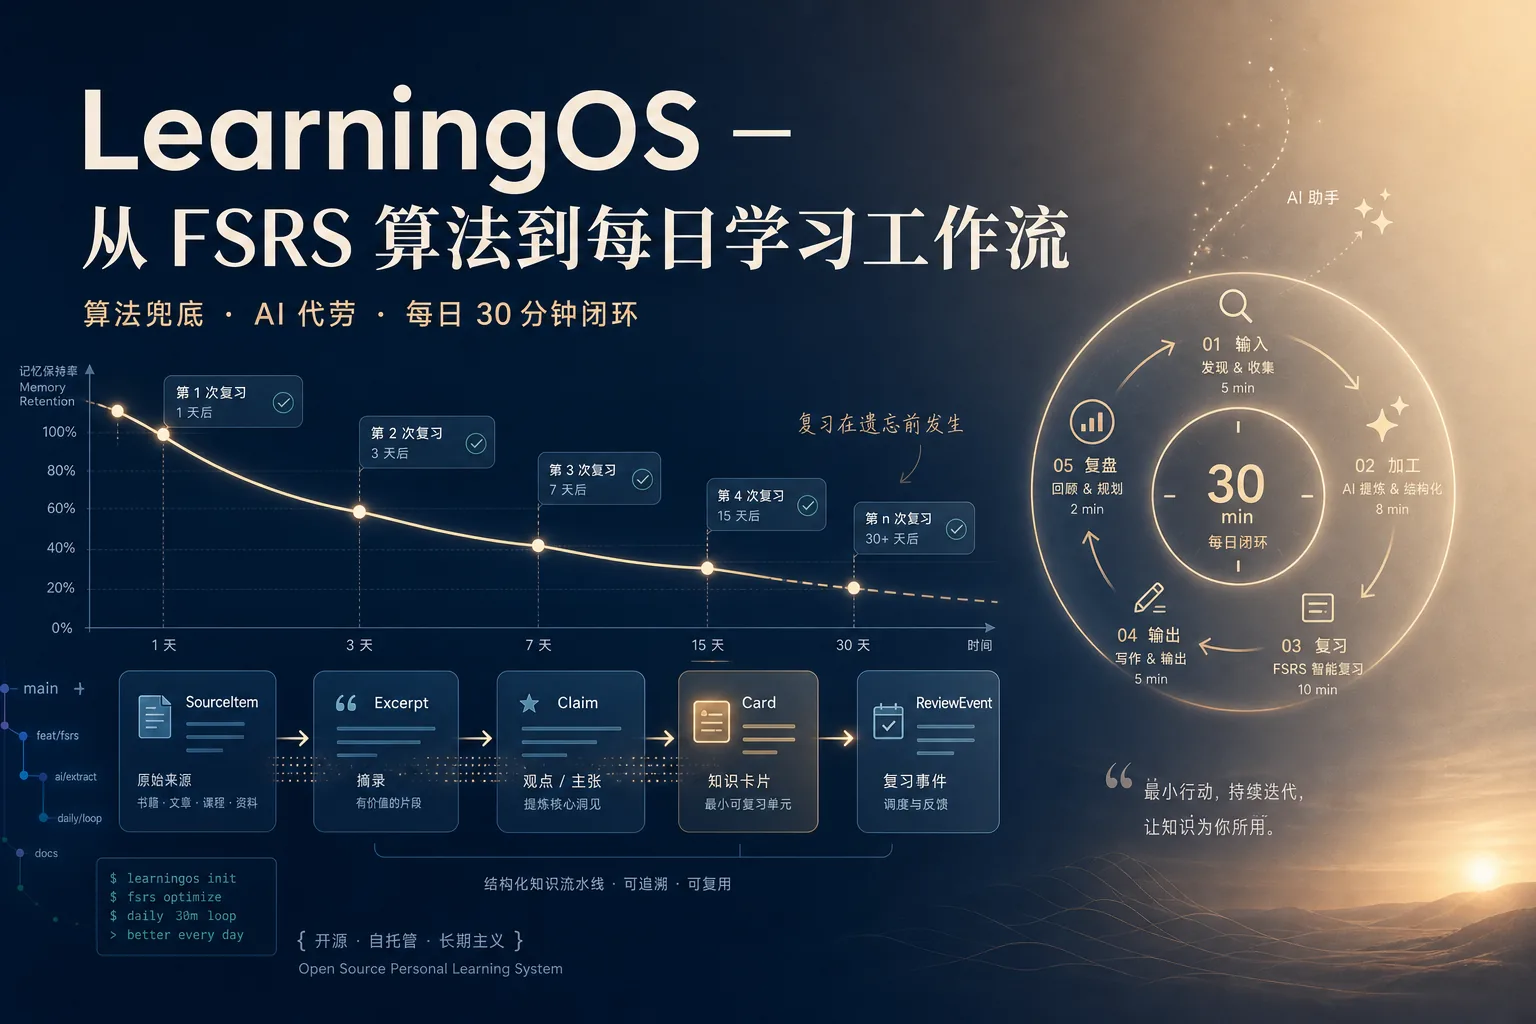
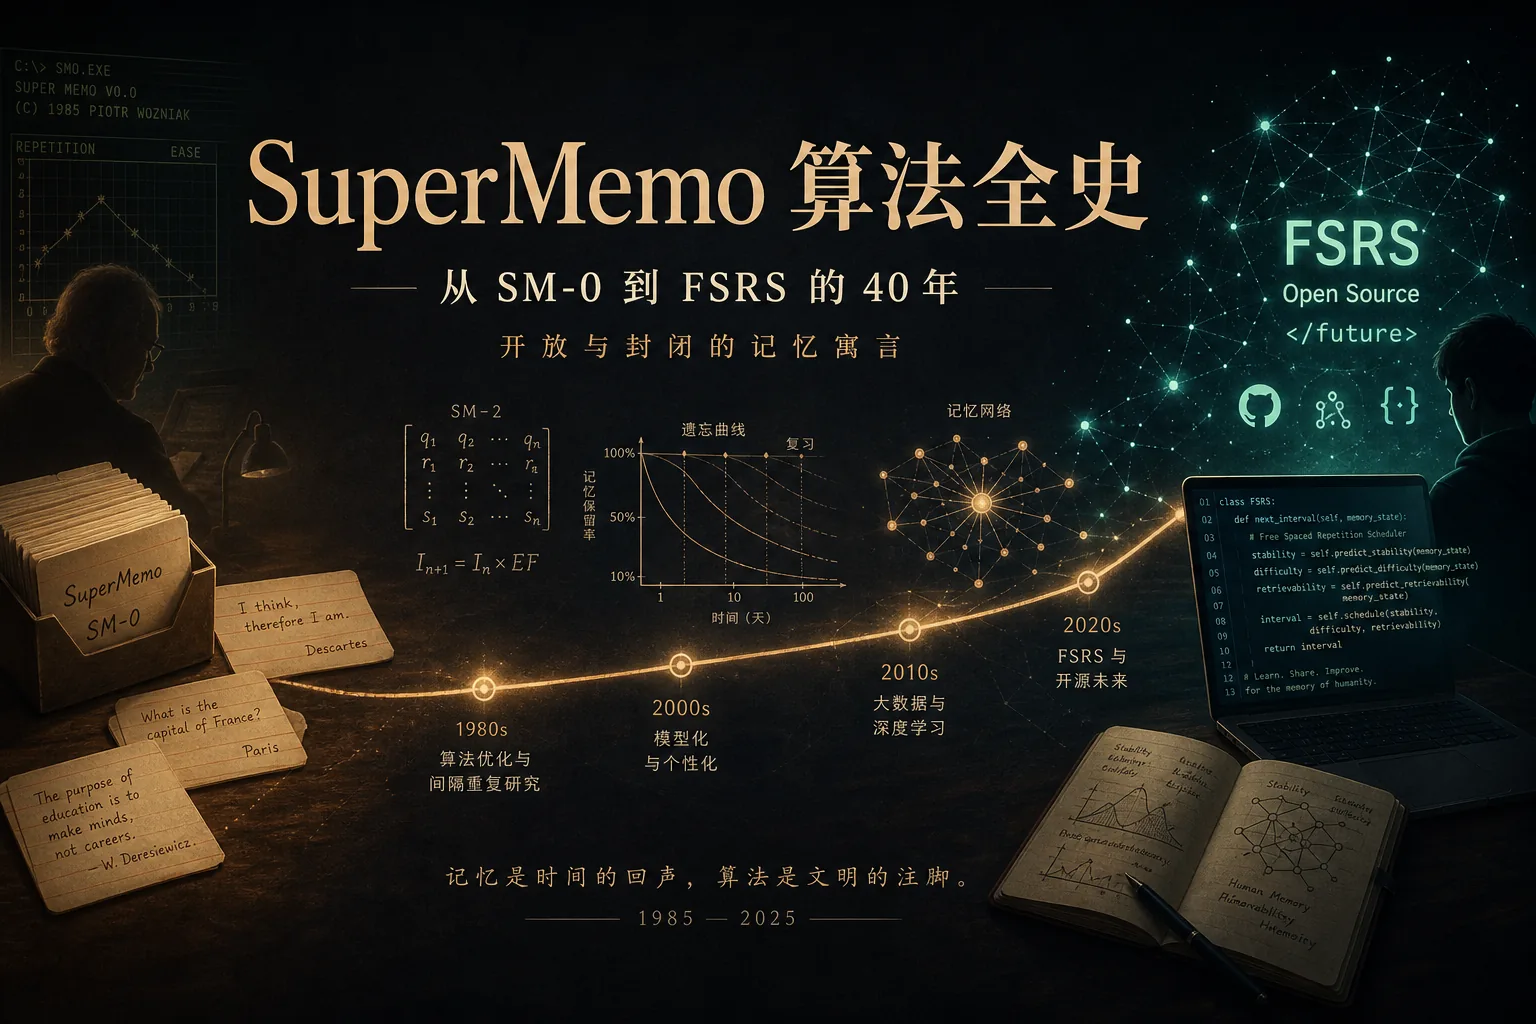
复习算法定为 FSRS(开源的现代间隔重复调度算法):它对每条记忆建模三个变量——难度、稳定性、可提取性,比沿用几十年的 SM-2 系(固定倍率递增)对真实遗忘曲线的拟合准得多,也是目前开源社区实证效果最好的一支。选型依据整理成文:SuperMemo 算法 40 年演进史。
自研捕获与前端
捕获端做类 Cubox 的多入口嵌入(浏览器 / iOS 分享 / 语音),前端阅读与复习界面自研、挂在自有体系之上。这两块是被竞品伤过才决定自研的部分:捕获依赖第三方就随第三方的产品变动漂移,前端依赖别家就永远在适应别人的交互假设。
当前进度
当前可确认:
- Aletheia 服务已经上线,仍在持续演化
- 两轮独立调研,不同模型分别执行、交叉验证结论
- 竞品全景与数据模型分析成文发布
- SuperMemo 四十年算法演进史整理,复习算法定案 FSRS
- FSRS 融入日常工作流的设计稿
仍需公开核验:素材捕获、LLM Wiki 编译、复习前端和数据 schema 的当前实现范围,需要以后续仓库、运行时与版本证据逐项确认;以下设计目标不等同于当前完成状态。
技术亮点与工程判断
- 调研先行到“过度”的程度:早期完成两轮交叉调研和算法史梳理——因为这是终生工程,选错底层(数据格式、复习算法)的代价按十年计,前期的慢是刻意的。
- 数据格式是唯一不可逆的决定:.md + 双链 + Git 之所以定得最早,是因为界面可以重写、算法可以换,唯独数据格式迁移伤筋动骨。最保守的格式给后面所有激进留了余地。
- AI 定位为编译器,不是聊天窗:把 AI 嵌进数据流水线(素材 → 知识页),而不是旁挂一个问答框——前者改变系统的能力结构,后者只是加了个功能。
- 和林爝的关系:通几是林爝的求知主线,负责知识进入、编译、复习与长期理解;星汉则承担获得公开许可后的表达与出版。
后续规划
后续公开演化仍遵循数据 schema → 捕获闭环 → LLM Wiki 编译 → 复习体验的依赖关系。每一步先在 Maple 自己的真实学习流里验证;对外状态以当前仓库、运行时与版本证据为准,不再沿用旧底稿的静态进度判断。
05